現状の課題
クリティカルなシステムでは、ノード障害への対応としてクラスタ構成による冗長化が行われている。しかし、クラスタ化にはコストが掛かるので、クラスタ構成を組めるのは一部のサーバーに限定される。そのため、クラスタ構成ではなく代替サーバーを用意しておき、ノード障害時にサーバーを切り替えて運用するケースがある。
ジョブの運用においても、ノード障害が発生してジョブが異常終了した場合、リカバリ策として、異常終了したジョブを別サーバーで手動実行することがある。ジョブ管理ツール上は異常終了したジョブをスキップ終了させる。その場合、後続のジョブが稼働しても、そのまた後続にノード障害を起こしたサーバーのジョブがあると、再度ジョブが異常終了してしまう。
解決策
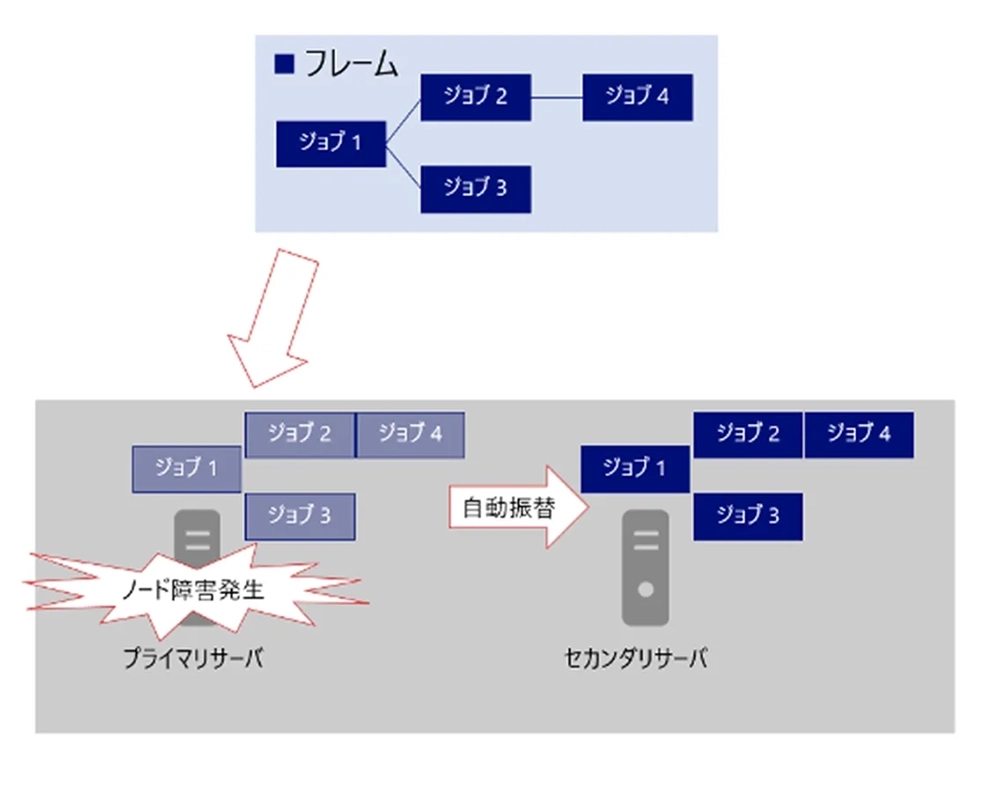
ノード障害を起こした場合は、障害が発生したサーバーで稼働する予定のジョブを、別のサーバーで実行するように切り替えることにより解決できる。具体的には、指定したサーバー(障害が発生したサーバー)で今後稼働する予定のジョブの一覧を抽出し、そのジョブ全てを別サーバーで稼働するように振り替えるのである。毎回手動で作業を行うとタイムラグが発生し、ミスの危険性もあるが、イベントをトリガーにした自動実行により、対応の迅速化と効率化が実現できる。
Senju Familyでの実践方法
Senju DevOperation Conductorでは、ジョブの実行サーバーとして、サーバーグループを指定することができる。サーバーグループ内の稼働しているサーバーの中で、一番負荷が低い(ジョブの実行数が少ない)サーバーに自動的にジョブの実行を振り分けることができる。
また、ジョブの実行(予定)サーバーを一括で置き換えるコマンドも実装している。メッセージアクション機能やランブックオートメーション機能と組み合わせて、サーバーのリソース監視(CPUやメモリーなど)で異常を検知したら一括で置き換えコマンドを自動実行する。そうすることで、実行サーバーの切り替えを自動化できる。